Formen addieren: Meine Bachelorarbeit über Minkowski-Summen
Inhaltsverzeichnis
Am 15. Juli 2019 habe ich meine Bachelorarbeit Berechnung der Minkowski-Summe für einfache Polygone abgegeben. Sie ist eine ziemlich mathematische Arbeit, aber das behandelte Problem hat eine anschauliche physikalische Interpretation: Welche Form entsteht, wenn man eine Form über eine andere bewegt und alle Positionen sammelt, die sie erreichen kann?
Dieser Beitrag ist die Fassung, die ich gerne parallel zur Bachelorarbeit geschrieben hätte. Er konzentriert sich auf die zentrale Idee, anstatt alle Definitionen, Beweise und Implementierungsdetails zu wiederholen.
Die Form, die durch Addition aller Punkte entsteht #
Für zwei Punktmengen A und B in der Ebene ist die Minkowski-Summe definiert als
A ⊕ B = {a + b | a ∈ A, b ∈ B}
Bei der Addition handelt es sich um Vektoraddition. Man wählt aus jeder Form einen Punkt, addiert ihre Koordinaten und erhält dadurch einen Punkt der Summe. Wiederholt man dies für jedes mögliche Paar, wird das Ergebnis vollständig ausgefüllt.
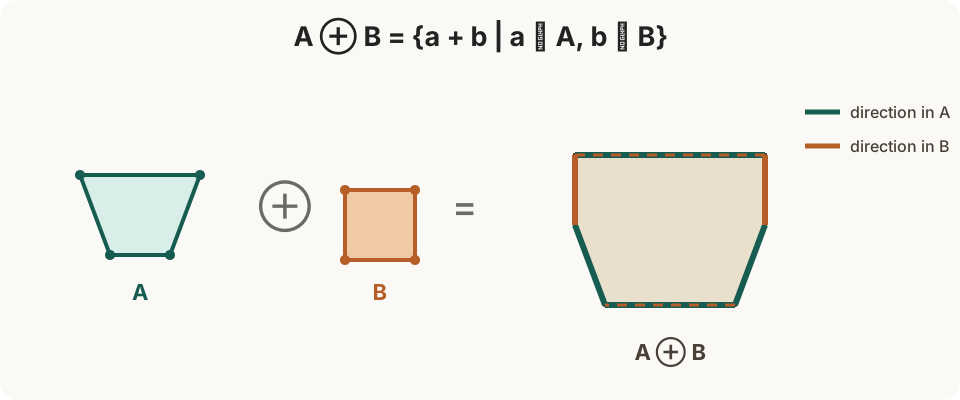
Die Definition ist einfach, ihre Implementierung jedoch nicht. Es gibt unendlich viele Punktpaare. Selbst die endliche Menge der Polygonecken beschreibt für sich genommen noch nicht das vollständige Ergebnis. Die entscheidende Beobachtung ist, dass der Rand genügend Struktur enthält, um das Ergebnis zu konstruieren.
Diese Operation findet sich überall dort, wo Geometrie und Algorithmen aufeinandertreffen:
- In der Bewegungsplanung kann ein Roboter, der nur verschoben werden darf, durch einen Referenzpunkt ersetzt werden. Für ein Hindernis O und die Roboterform R bilden die verbotenen Positionen dieses Punktes die Menge O ⊕ (−R). Dabei ist −R die am Referenzpunkt gespiegelte Roboterform.
- Bei CNC-Verfahren und im 3D-Druck wird die Geometrie um die Grundfläche des Werkzeugs oder der Düse versetzt, um Wege für den jeweiligen Referenzpunkt abzuleiten.
- Bei der Kollisionserkennung und Bildverarbeitung wird dieselbe Operation als geometrische Form der Dilatation verwendet.
Der einfache Fall: konvexe Polygone #
Für zwei konvexe Polygone bieten sich zwei Algorithmen an.
Der direkte Ansatz bildet jede Eckpunktsumme vᵢ + wⱼ und berechnet anschließend die konvexe Hülle. Bei n und m Ecken entstehen zunächst n · m Kandidaten. Der Hüllenalgorithmus entfernt danach alle Punkte, die nicht auf dem Rand liegen können.
Der bessere Algorithmus nutzt aus, dass die Kanten eines gegen den Uhrzeigersinn orientierten konvexen Polygons bereits zyklisch nach ihrer Richtung geordnet sind. In der Formulierung der Bachelorarbeit beginnt man in jedem Polygon beim xy-lexikografisch kleinsten Eckpunkt und addiert diese beiden Startpunkte. Anschließend werden die beiden Kantenfolgen anhand ihrer Polarwinkel zusammengeführt. In jedem Schritt rückt man entlang der Kante mit dem kleineren Winkel vor und fügt danach die nächste Eckpunktsumme hinzu. Zeigen beide Kanten in dieselbe Richtung, rückt man in beiden Polygonen vor. Die resultierende Kante entspricht der Summe der beiden Kantenvektoren. Jede Eingabekante wird genau einmal verarbeitet, wodurch sich eine Laufzeit von O(n + m) ergibt.
Darin steckt eine kleine, aber wichtige algorithmische Erkenntnis: Die Geometrie liefert uns die Ordnung kostenlos. Sobald wir sie nutzen, müssen wir nicht mehr alle möglichen Eckpunktpaare erzeugen und sortieren.
Warum konkave Polygone alles verändern #
Bei konkaven Polygonen funktioniert dieser einmalige Rundgang nicht mehr. Die Summe zweier konkaver Polygone kann Einbuchtungen und mehrere Randkomponenten in Zwischenkonstruktionen enthalten. Außerdem können sich Kanten überlagern oder schneiden. Eine lokale Entscheidung über die nächste Kante reicht nicht mehr aus, um zu bestimmen, welche Teile im endgültigen Rand erhalten bleiben.
Der Hauptteil meiner Bachelorarbeit verwendet deshalb die Konvolutionsmethode. Ihre wesentliche Idee besteht darin, zunächst eine bewusst redundante Anordnung zu konstruieren und erst danach zu entscheiden, welche Teile zur Minkowski-Summe gehören.
Der Algorithmus in drei Ideen #
1. Kanten um Eckpunkte verschieben #
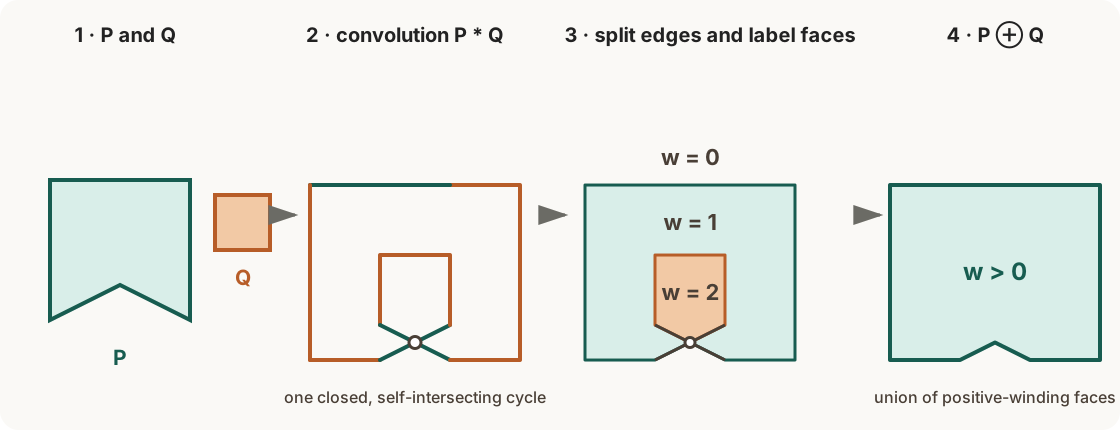
Wir nehmen an, dass die Ränder beider Polygone gegen den Uhrzeigersinn orientiert sind. Eine orientierte Kante pᵢpᵢ₊₁ des Polygons P wird um einen Eckpunkt qⱼ des Polygons Q verschoben. Dadurch entsteht das Segment [pᵢ + qⱼ, pᵢ₊₁ + qⱼ]. Dieses Segment wird nur aufgenommen, wenn seine Richtung in dem Winkelintervall liegt, das von den beiden an qⱼ angrenzenden Kanten aufgespannt wird. Dieselbe Konstruktion wird symmetrisch für jede Kante von Q und den jeweils passenden Eckpunkt von P durchgeführt.
Die ausgewählten Kanten-Eckpunkt-Verschiebungen bilden die Konvolution. Ihre Segmente verbinden sich zu geschlossenen Kurven, die jedoch nicht einfach sein müssen. Ist mindestens eines der Eingabepolygone konvex, erzeugt der Algorithmus der Bachelorarbeit einen Konvolutionskreis. Bei zwei konkaven Polygonen können mehrere Kreise erforderlich sein. Diese Kurven enthalten Kandidaten für den Rand des Ergebnisses. Sie können sich schneiden oder Regionen einschließen, die nicht zum Ergebnis gehören.
Ein einzelner Konvolutionskreis enthält höchstens O(nm) Segmente. Die Konstruktion aller erforderlichen Kreise für zwei konkave Polygone benötigt im Algorithmus der Bachelorarbeit O(n² · m²) Zeit.
2. Segmente in eine planare Datenstruktur überführen #
Die Segmente werden an allen Schnittpunkten geteilt und in einer doppelt verketteten Kantenliste (DCEL) gespeichert. Eine DCEL erfasst Eckpunkte, gerichtete Halbkanten, ihre Zwillinge, die jeweils nächste Kante am Rand einer Fläche und die Fläche, an die jede Kante grenzt.
Diese Datenstruktur bildet die Brücke zwischen Geometrie und Topologie. Anstatt komplizierte Fragen für jeden einzelnen Punkt zu beantworten, können wir den Rand jeder Fläche in der Anordnung ablaufen und daraus Schlussfolgerungen ziehen. Die Implementierung muss außerdem deckungsgleiche oder überlappende Segmente verarbeiten. Dieses unscheinbare Detail wird entscheidend, wenn Koordinaten durch Java-double-Werte dargestellt werden.
3. Das Ergebnis mithilfe von Windungszahlen auswählen #
Die Konvolution beschreibt mehr als nur die Minkowski-Summe. Im letzten Schritt müssen die Flächen klassifiziert werden. Der Algorithmus berechnet für jede Fläche ihre Windungszahl. Vereinfacht gesagt gibt sie an, wie oft die orientierte Konvolution einen Punkt innerhalb dieser Fläche umläuft.
Flächen mit einer positiven Windungszahl gehören zu P ⊕ Q. Gleichbedeutend damit folgt die Implementierung den Halbkanten neben der unbegrenzten Fläche, um den äußeren Rand zu erhalten. Begrenzte Flächen mit der Windungszahl null werden als Löcher behandelt. Eine Fläche mit der Windungszahl zwei gehört weiterhin zum Ergebnis und ist kein Loch. Der Algorithmus versucht also nicht, den endgültigen Rand bereits während seiner Konstruktion zu erraten. Stattdessen konstruiert er alle plausiblen Ränder, beschriftet die Regionen und filtert die Anordnung mithilfe einer topologischen Invariante.
Diese Trennung ist die zentrale Idee der Bachelorarbeit:
Die Geometrie schlägt Kanten vor. Die Topologie entscheidet, welche Regionen erhalten bleiben.
Was die Implementierung schwierig machte #
Die mathematische Beschreibung ist übersichtlich. Im Code verbergen sich die Sonderfälle.
Ich habe die Algorithmen in Java 8 mit dem ADSToolbox-Framework der Universität Bayreuth implementiert und getestet.
Von Rundung zu expliziten Vergleichsregeln #
Dass bei Gleitkommaberechnungen Rundungsfehler auftreten, war nicht überraschend. Überrascht hat mich, wie schnell aus einer winzigen numerischen Abweichung ein topologischer Fehler werden kann. Sollten sich drei Segmente in einem Punkt treffen, die Berechnungen erzeugen aber zwei fast identische Punkte, erkennt die DCEL keinen gemeinsamen Eckpunkt mehr. Halbkanten können unverbunden bleiben, Flächen schließen sich möglicherweise nicht und Windungszahlen können falsch werden.
Exakte Gleichheit ist bei berechneten double-Werten deshalb meistens die falsche Frage. Die Implementierung der Bachelorarbeit ging damit defensiv um. Sie versuchte die Berechnung zunächst ohne Rundung. Schlugen die Konsistenzprüfungen der DCEL fehl, wiederholte sie den Versuch mit schrittweise gröberer Dezimalrundung bis hinunter zu vier Nachkommastellen. Ich erwog außerdem den Einsatz von BigDecimal, aber die Anpassung des umgebenden, auf double basierenden Frameworks lag außerhalb des Umfangs der Bachelorarbeit.
Später habe ich mich in meiner quelloffenen Kotlin-Multiplatform-Bibliothek Komp-Geom bewusster mit diesem Problem beschäftigt. Anstatt direkte Vergleiche und willkürliche Toleranzen über die Algorithmen zu verteilen, bildet die Bibliothek die Vergleichsstrategie über ein DoubleEquivalence-Interface ab. Die Standardimplementierung betrachtet zwei Werte als gleichwertig, wenn
|a − b| ≤ ε · max(1, |a|, |b|)
mit standardmäßig ε = 10⁻¹⁰ gilt. In der Nähe von null verhält sich dies wie eine absolute Toleranz. Bei größeren Werten skaliert die Toleranz mit ihrem Betrag. Dieselbe Strategie stellt Operationen für Gleichheit, den Vergleich mit null und Größenvergleiche bereit. Geometrische Operationen können eine andere Äquivalenz erhalten, wenn ihr Maßstab oder ihre Anforderungen dies verlangen.
Das ist ein besserer Entwurf, als rohe ==-Vergleiche in einer Geometriebibliothek zu verstecken. Es ist jedoch kein universelles Heilmittel. Näherungsweise Gleichheit hängt vom Maßstab und vom Zweck einer Berechnung ab und ist im mathematischen Sinn nicht transitiv. Algorithmen, die stärkere Garantien benötigen, können exakte oder adaptive geometrische Prädikate erfordern. Die wichtigste Erkenntnis für mich ist, dass der Vergleich von Zahlen zum Entwurf und zur API eines Algorithmus gehört und nicht in eine nachträglich ergänzte Sammlung von Sonderfällen.
Einige weitere praktische Erkenntnisse aus der Bachelorarbeit sind mir ebenfalls geblieben:
- Eingaben früh normalisieren. Eine einheitliche Orientierung und das Entfernen redundanter Eckpunkte vereinfachen jeden späteren Schritt.
- Redundante Objekte vermeiden. Die Konvolution kann schnell wachsen. Unnötige Allokationen und wiederholte Berechnungen werden dadurch teuer.
- Datenstrukturen passend zum Zugriffsmuster wählen. In einem Teil des Algorithmus ist der wahlfreie Zugriff auf eine Folge wichtig. Eine verkettete Liste würde aus einer linearen Operation unbemerkt eine quadratische machen.
- Nicht nur Koordinaten, sondern auch die Topologie testen. Zusätzlich zu manuell berechneten JUnit-Fällen prüfte die Implementierung, ob jede Halbkante einen Vorgänger und einen Nachfolger besitzt, jeder Flächenrand ein einfaches Polygon bildet und jede Randkante dieselbe Windungszahl für ihre Fläche ergibt.
Die Laufzeit der Konvolutionsmethode ist für zwei einfache Polygone durch O(n² · m²) beschränkt. Sowohl die Konstruktion aller Konvolutionskreise für zwei konkave Eingaben als auch die DCEL im schlechtesten Fall haben in der Bachelorarbeit diese Schranke. Die Experimente zeigen außerdem, warum die Anordnung in der Praxis den größten Aufwand verursacht. In einem Beispiel enthielt die DCEL 5.794 Halbkanten, von denen nur 27 den äußeren Rand des Ergebnisses bildeten. Die Methode ist nicht das letzte Wort bei Minkowski-Summen, aber sie ist ein allgemeines Verfahren für den in der Bachelorarbeit behandelten nicht konvexen Fall.
Rückblick #
Mir gefällt an diesem Projekt, dass die sichtbare Form das Ergebnis mehrerer gedanklicher Ebenen ist: Vektoraddition, Kantenorientierung, planare Unterteilungen und Windungszahlen. Keine dieser Ideen reicht für sich allein aus. Gemeinsam verwandeln sie eine kontinuierliche geometrische Definition in einen endlichen Algorithmus.
Der naheliegende nächste Schritt, den ich bereits in der Bachelorarbeit beschrieben habe, ist eine reduzierte Konvolution. Sie lässt Segmente aus, die an reflexiven Eckpunkten entstehen und nicht zum Rand beitragen können. Dadurch entstehen weniger Schnittpunkte und es fällt weniger Verwaltungsaufwand an. Gleichzeitig werden jedoch die geschlossenen Konvolutionskreise aufgebrochen, weshalb Windungszahlen allein das Ergebnis nicht mehr klassifizieren können. Stattdessen sind zusätzliche geometrische Filter erforderlich. Diesen Kompromiss zu implementieren und zu untersuchen wäre ein naheliegendes Folgeprojekt.
Wenn ich dies Jahre später aufschreibe, wird auch die allgemeinere Erkenntnis deutlicher: Wird eine direkte Konstruktion unübersichtlich, kann es wirkungsvoller sein, zunächst eine reichhaltige Zwischenrepräsentation aufzubauen und die Antwort anschließend mit der passenden Invariante daraus zu extrahieren.