Graphify vs. grep: Hilft ein Wissensgraph einem KI-Coding-Agenten?
Inhaltsverzeichnis
Gib
/graphifyin deinen KI-Coding-Assistenten ein, und er bildet dein gesamtes Projekt (Code, Dokumentation, PDFs, Bilder und Videos) als Wissensgraph ab, den du anstelle einer Dateisuche abfragen kannst.
Diese Behauptung steht prominent im Graphify-Repository. Sie hat sofort meine Aufmerksamkeit geweckt. grep und Werkzeuge wie rg sind alt, einfach und zuverlässig. Ein Wissensgraph klingt deutlich ausgefeilter, aber Ausgefeiltheit allein macht ein Werkzeug noch nicht nützlich.
Hinter dem Marketingvergleich steckt außerdem eine interessantere Frage. KI-Coding-Agenten erkunden Repositories nicht genau so wie Menschen. Sie führen viele Suchen aus, lesen Dateiausschnitte, verfolgen Symbole über Module hinweg und fügen Ergebnisse wiederholt ihrem Kontext hinzu. Vielleicht kann ein Graph einem Agenten einen besseren Ausgangspunkt geben und einen Teil dieser Arbeit vermeiden.
Ich habe diese Idee am FastAPI-Repository getestet. Ich stellte demselben Coding-Agenten zwölf Fragen, einmal mit Zugriff auf Graphify und einmal ohne. Gemessen habe ich Zeit, Werkzeugnutzung, untersuchte Dateien, Tokens und Kosten.
Was Graphify tatsächlich erstellt #
Graphify ist keine Vektordatenbank. Laut seiner Beschreibung des Extraktionsprozesses erstellt es den Graphen in mehreren Durchläufen:
- Tree-sitter extrahiert die Code-Struktur, einschließlich Klassen, Funktionen, Imports und Aufrufen.
- Audio und Video können lokal transkribiert werden.
- Dokumentation, wissenschaftliche Arbeiten, Bilder und Transkripte können von einem LLM semantisch extrahiert werden.
Die entstehenden Knoten stehen für Dinge wie Dateien, Symbole und Konzepte. Kanten beschreiben Beziehungen wie calls, imports und implements. Graphify kennzeichnet Beziehungen als EXTRACTED, INFERRED oder AMBIGUOUS. Das ist wichtig, weil nicht jede Beziehung im Graphen denselben Beweiswert hat. Anschließend gruppiert der Leiden-Algorithmus dicht verbundene Knoten in Communities.
Das Projekt erzeugt einen maschinenlesbaren Graphen, einen Bericht und eine interaktive HTML-Visualisierung. Dies ist der Graph aus meinem FastAPI-Checkout:
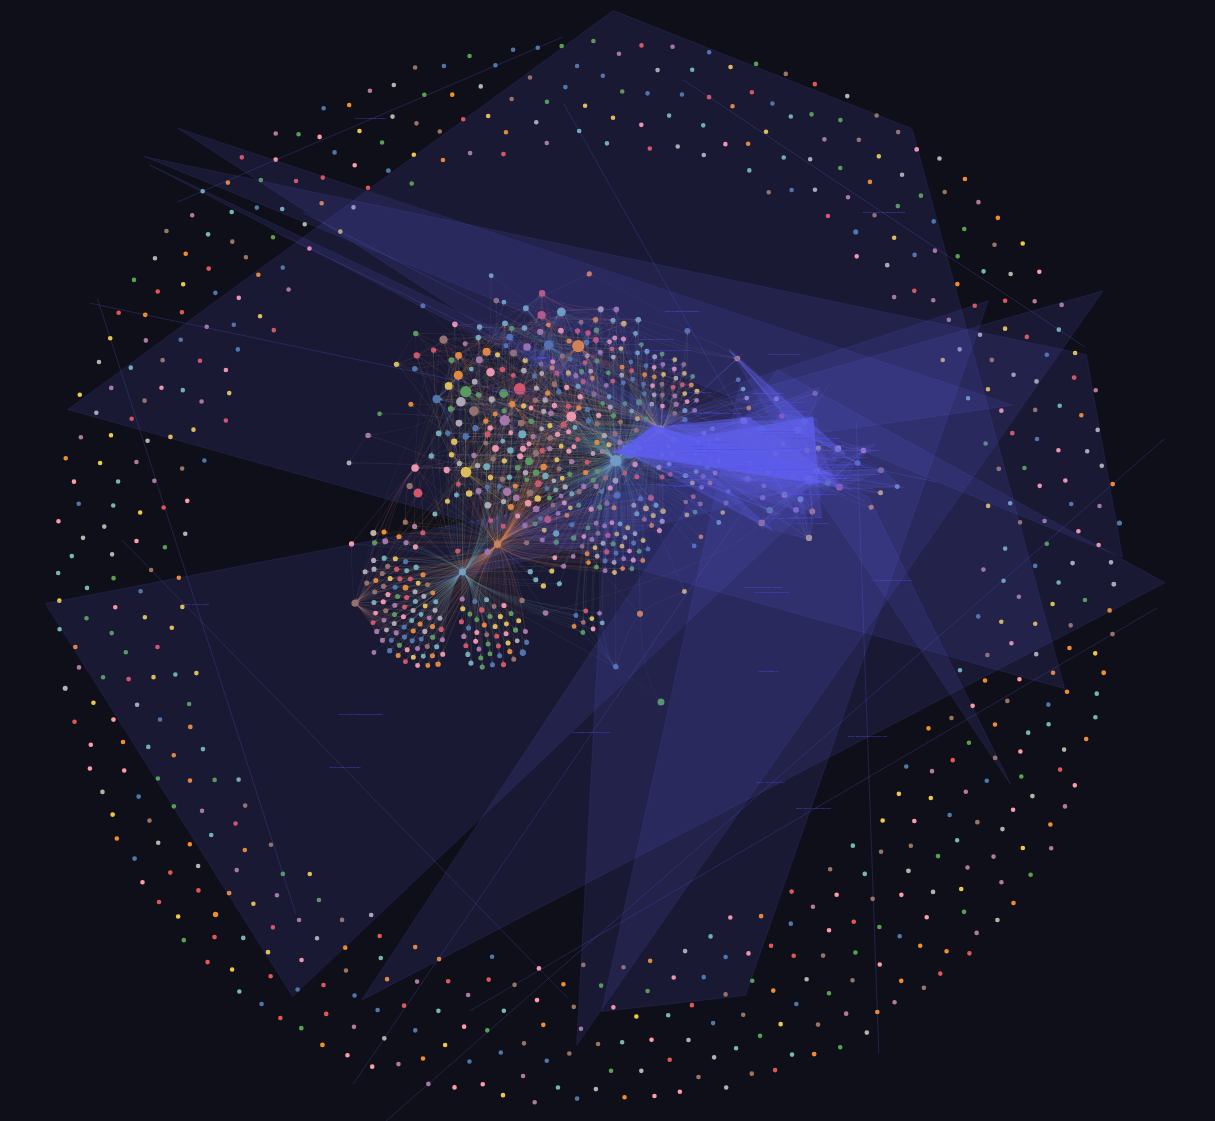
Die Visualisierung ist beeindruckend, aber in meinem Experiment geht es nicht darum, ob Graphify einen Graphen zeichnen kann. Es geht darum, ob dieser Graph einem Agenten hilft, realistische Fragen zu einem Repository mit weniger Arbeit zu beantworten.
Die Warnung für große Korpora ist wichtig #
Graphifys aktueller Skill warnt, wenn ein Korpus mehr als 500 unterstützte Dateien oder 2.000.000 Wörter enthält, und bittet den Nutzer, den Umfang einzugrenzen. FastAPI überschritt die Dateigrenze, aber ich habe absichtlich mit dem gesamten Repository weitergemacht, um Implementierungscode, Tests und Dokumentation einzubeziehen.
Das gab Graphify viele Informationen, erhöhte aber auch die Erstellungskosten und bezog Material ein, das für manche Fragen irrelevant war. Die Warnung ist sinnvolles Produktverhalten. Sie schränkt jedoch das Versprechen ein, ein „gesamtes Projekt“ abzubilden. Einen einzigen riesigen Graphen zu bauen ist nicht automatisch besser, als den für die Arbeit relevanten Teil eines Repositories zu indexieren.
Aufbau des Experiments #
Graphifys README verwendet einen FastAPI-Graphen als Hauptbeispiel, daher habe ich dasselbe Projekt genutzt. Der Checkout enthielt FastAPI Version 0.141.1 im Commit 50113da. Die exportierten Sitzungen bewahren außerdem die vom Agenten verwendeten Dateien und Zeilenreferenzen.
Ich verwendete:
- Graphify
0.9.55 - OpenAIs
gpt-5.6-lunafür die Coding-Agent-Sitzungen - den pi coding agent als Agenten-Harness
- eine neue Sitzung pro Frage
Ich prüfte die Produkt- und Benchmarkbehauptungen des Repositories im Commit c7ec108, der sich als Version 0.9.62 ausweist. Das Experiment verwendete 0.9.55, daher können sich aktuelles Verhalten oder aktuelle Behauptungen unterscheiden.
Ich erzeugte den Graphen mit:
uv tool install 'graphifyy[sql,openai]'
graphify extract . --openai
graphify cluster-only . --openai
Die Graph-Erzeugung verbrauchte 3,8 Millionen Eingabe-Tokens und 349.000 Ausgabe-Tokens. Das gemischte Korpus enthält umfangreiche Dokumentation und andere Assets. Das Ergebnis beschreibt daher die getesteten Optionen und diesen Korpus, nicht das günstigste mögliche code-only Setup.
Danach verwendete ich zwei Agentenkonfigurationen:
- Ohne Graphify: normale Repository-Werkzeuge wie Suche und Dateilesen
- Mit Graphify: dieselben Werkzeuge plus Graphify-Skill und erzeugter Graph
Beide Konfigurationen erhielten dasselbe Modell, dieselbe Frage, dasselbe Antwortformat und denselben Repository-Zustand. Die Behandlung war gewöhnliche Repository-Erkundung im Vergleich zu Repository-Erkundung mit Graphify-Skill, erzeugtem Graphen und Graphify-Abfragewerkzeugen. Der Vergleich misst daher den praktischen Effekt, Graphify zum Agenten hinzuzufügen, statt den Graphen von Skill-Anweisungen und Werkzeugen zu isolieren.
Fragen #
Ich teilte die Fragen in drei Gruppen ein. Graphify-spezifische Begriffe vermied ich, damit die Prompts Fragen ähneln, die beim Einstieg in ein unbekanntes Projekt gestellt werden.
Einfache Navigation #
Diese Fragen testen, ob Graphify bei Aufgaben, die eine Quellsuche bereits gut erledigt, unnötigen Aufwand erzeugt.
- Q1: Wo ist die Klasse
FastAPIdefiniert? - Q2: Wo befindet sich die Logik für den Anwendungsstart?
- Q3: Welche Datei definiert die relevante Konfigurationsoption?
- Q4: Wo werden HTTP-Exceptions in Antworten umgewandelt?
Q3 ist nicht präzise genug. Ich behielt die Frage als Fallstudie für Mehrdeutigkeit bei, schloss sie aber aus den Gesamtsummen und den Mittelwerten nach Fragetyp aus. Ihr Ergebnis bleibt zur Kontrolle in den Rohdaten. In einem künftigen Durchlauf würde ich sie durch eine konkrete Konfigurationsoption ersetzen.
Beziehungsfragen #
Diese Fragen erfordern, Beziehungen über die Codebasis hinweg zu verfolgen.
- Q5: Zeichne den Weg von einer eingehenden Anfrage bis zu einem Route-Handler nach.
- Q6: Wie werden Abhängigkeiten aufgelöst, bevor eine Route aufgerufen wird?
- Q7: Wie arbeitet Middleware mit der Exception-Behandlung zusammen?
- Q8: Wie ist eine registrierte Route mit der OpenAPI-Schemaerzeugung verbunden?
Fragen zu Änderungsfolgen #
Hier soll der Agent abschätzen, welche Teile des Repositories von einer Änderung betroffen wären.
- Q9: Welche Dateien müssten geändert werden, um eine neue Middleware-Konfigurationsoption hinzuzufügen?
- Q10: Wo würdest du den Code ändern, um die Fehlerbehandlung von Abhängigkeiten zu ändern?
- Q11: Welche Teile des Projekts wären von einer Änderung der Routenregistrierung betroffen?
- Q12: Welche Tests sollten bei einer Änderung der OpenAPI-Erzeugung aktualisiert werden?
Für diese Fragen gibt es keine einzige definitive Dateiliste. Verschiedene Implementierungen können gültig sein. Daher behandle ich sie als Erkundungsaufgaben und nicht als Fragen mit einer einfachen Musterlösung.
Prompt #
Jede Sitzung erhielt diesen Prompt:
I am new to the FastAPI project and have a Question:

[Question]

Provide:
1. A concise answer to the question.
2. The reasoning path you followed.
3. Relevant files, symbols, and line numbers.
4. Any uncertainty or assumptions.
Was ich gemessen habe #
Für jede Sitzung erfasste ich:
- Zeit: verstrichene Zeit bis zur ersten brauchbaren Antwort. Ich zählte die erste Antwort, die die Frage beantwortete und mindestens eine überprüfbare Datei- oder Symbolreferenz enthielt. Vollständige Korrektheit war keine Voraussetzung, da ich die Korrektheit nicht unabhängig bewertet habe.
- Dateien: eindeutige untersuchte Repository-Dateien
- Werkzeugaufrufe: alle Werkzeugaufrufe
- Graph-Aufrufe: Aufrufe, die Graphify abfragten
- Gesamteingabe: nicht gecachte Eingabe sowie Prompt-Cache-Lese- und Schreibvorgänge über alle Modellaufrufe
- Ausgabe: erzeugte Ausgabe-Tokens
- Beobachtete Kosten: vom Provider geschätzte Kosten in US-Dollar einschließlich des während der Sitzung aufgezeichneten Cache-Verhaltens
Gesamteingabe ist nicht die Zahl der von der Festplatte gelesenen Quellcode-Tokens. Es handelt sich um die verarbeitete Eingabe der gesamten Agentensitzung. Wiederholter Konversationskontext, Werkzeugergebnisse und Graphify-Ausgabe tragen alle dazu bei. Die exportierten Sitzungsdaten trennen Skill-Anweisungen, Graph-Abfrageausgabe, Quellwerkzeugausgabe und wiederholten Kontext nicht. Daher kann ich nicht feststellen, welche Komponente den Unterschied zwischen den Konfigurationen verursacht hat.
Ergebnisse #
Gesamtergebnis #
Über die elf einbezogenen Fragen hinweg ergaben sich folgende Summen:
| Metrik | Ohne | Mit | Änderung |
|---|---|---|---|
| Zeit | 468 s | 511 s | +9,2 % |
| Dateien | 89 | 76 | -14,6 % |
| Tools | 175 | 160 | -8,6 % |
| Input | 1.974.282 | 2.951.731 | +49,5 % |
| Output | 27.638 | 27.204 | -1,6 % |
| Kosten | $0,1687 | $0,1847 | +9,5 % |
Graphify verringerte die Zahl der untersuchten Dateien in acht einbezogenen Fragen, mit einem Gleichstand und zwei Fällen mit mehr Dateien. Die Zahl der Werkzeugaufrufe sank in sieben Fragen und stieg in vier. Graphify war in vier Fragen schneller und in sieben langsamer, verbrauchte in keiner Frage weniger Eingabe und hatte in zwei Fällen niedrigere beobachtete Kosten.
Das ist das zentrale Ergebnis. Graphify gab dem Agenten meist eine kleinere Menge von Quelldateien, aber Abfragen und Verarbeitung des Graphen erzeugten genug zusätzlichen Kontext und Aufwand, um die erwartete Tokenersparnis aufzuheben. Bei den gemessenen Effizienzergebnissen schnitt Graphify insgesamt schlechter ab. Da ich die Antwortqualität nicht bewertet habe, kann das Experiment nicht zeigen, ob die zusätzlichen Kosten bessere oder vollständigere Antworten erkauft haben.
Dateien und Werkzeugaufrufe sind außerdem nur Proxy-Metriken, keine Nutzerergebnisse. Eine Graph-Abfrage kann mehr Text zurückgeben als mehrere gezielte Suchen, und weniger untersuchte Dateien helfen nicht, wenn die Antwort langsamer, teurer oder weniger vollständig ist. Dieses Experiment misst Erkundungsaufwand, nicht Antwortkorrektheit. Bei Zeit, Eingabe und beobachteten Kosten schnitt Graphify insgesamt schlechter ab. Ob der zusätzliche Aufwand bessere Antworten erzeugte, kann ich nicht sagen.
Die Ausgabe-Totale waren nahezu identisch. Der große Unterschied liegt auf der Eingabeseite, wo die Graphify-Konfiguration über die elf einbezogenen Sitzungen fast eine Million zusätzliche Tokens verarbeitete.
Ergebnisse nach Fragetyp #
Mittelwerte zeigen ein nützlicheres Muster als die Gesamtsumme:
| Typ | Setup | Zeit | Dateien | Tools | Input | Output | Kosten |
|---|---|---|---|---|---|---|---|
| Navigation | Ohne | 26,0 s | 5,3 | 11,7 | 97.772 | 1.910 | $0,0103 |
| Navigation | Mit | 39,0 s | 4,0 | 11,7 | 195.548 | 1.550 | $0,0122 |
| Beziehungen | Ohne | 35,0 s | 5,3 | 13,8 | 181.467 | 2.647 | $0,0156 |
| Beziehungen | Mit | 52,8 s | 4,5 | 18,3 | 295.205 | 2.885 | $0,0180 |
| Änderungen | Ohne | 62,5 s | 13,0 | 21,3 | 238.775 | 2.830 | $0,0189 |
| Änderungen | Mit | 45,8 s | 11,5 | 13,0 | 296.067 | 2.754 | $0,0191 |
Einfache Navigation brauchte keinen Graphen #
Bei den drei einbezogenen Fragen zur einfachen Navigation untersuchte Graphify durchschnittlich 1,3 Dateien weniger, brauchte aber 13 Sekunden länger und verarbeitete 100 % mehr Eingabe. class FastAPI zu finden ist genau die Art von Aufgabe, bei der eine exakte Quellsuche schwer zu schlagen ist.
Q1 ist repräsentativ. Der Graphify-Agent fragte den Graphen ab, suchte nach der exakten Deklaration, las fastapi/applications.py und prüfte den öffentlichen Re-Export in fastapi/__init__.py. Der Graph zeigte den relevanten Bereich, aber der Agent benötigte weiterhin gezielte Quellsuchen und Dateilesen, um Antwort und Zeilennummern zu überprüfen.
Das ist kein Versagen des Graphen, sondern eine fehlende Passung zwischen Werkzeug und Aufgabe. Eine Symbollsuche hat bereits ein ausgezeichnetes Signal-Rausch-Verhältnis.
Beziehungsfragen waren die schwächste Kategorie #
Ich hatte erwartet, dass Graphify bei Beziehungsfragen am besten abschneidet. Stattdessen zeigte diese Kategorie die größte Verlangsamung. Die durchschnittliche Zeit stieg von 35,0 auf 52,8 Sekunden, die Werkzeugaufrufe von 13,8 auf 18,3 und die Eingabe um 62,7 %.
Beide Konfigurationen fanden im Allgemeinen dieselben zentralen Implementierungspfade. Zum Beispiel verfolgten beide Antworten auf Q5 die Anfrage durch Anwendung, Middleware, Router, Abhängigkeitsauflösung, Endpunktaufruf und Antwortserialisierung. Beide verwiesen auf fastapi/applications.py, fastapi/routing.py und fastapi/dependencies/utils.py.
Der Graph machte die Quellinspektion nicht überflüssig. In jeder Graphify-Sitzung fragte der Agent zuerst Graphify ab und nutzte anschließend Suchen und Dateilesen, um die zurückgegebenen Beziehungen zu bestätigen. Diese Überprüfung ist besonders bei abgeleiteten Kanten sinnvoll, bedeutet aber, dass der Graph eine zusätzliche Navigationsebene und keinen Ersatz für die Quellsuche darstellt.
Breite Fragen zu Änderungsfolgen waren vielversprechender #
Die Kategorie der Änderungsfolgen zeigt ein anderes Bild. Graphify senkte die durchschnittliche Zeit von 62,5 auf 45,8 Sekunden und die Werkzeugaufrufe von 21,3 auf 13,0. Auch die durchschnittliche Zahl untersuchter Dateien sank von 13,0 auf 11,5.
Q12 zeigte die deutlichste Verbesserung. Die Sitzung ohne Graphify dauerte bei der Suche in der Testsuite 101 Sekunden und 29 Werkzeugaufrufe. Die Graphify-Sitzung dauerte 47 Sekunden und 15 Werkzeugaufrufe. Beide untersuchten weiterhin viele Dateien, aber der Graph scheint eine nützliche erste Karte der OpenAPI-bezogenen Tests geliefert zu haben.
Diese Kategorie enthält nur vier Einzelmessungen, und Q12 ist ein auffällig langsamer Lauf ohne Graphify. Ohne Wiederholungen oder eine Bewertung der Antwortqualität kann ich nicht feststellen, wie viel des scheinbaren Gewinns vom Graphen und wie viel von der normalen Agentenvarianz stammt. Der Zielkonflikt bleibt außerdem bestehen. Fragen zu Änderungsfolgen verbrauchten mit Graphify 24,0 % mehr Eingabe, während die durchschnittlichen Kosten nahezu identisch waren. Ich sehe dies als Ansatzpunkt für ein besseres Experiment, nicht als Beleg dafür, dass Graphify Änderungsanalysen verbessert.
Vergleich mit Graphifys Benchmarks #
Graphify veröffentlicht zwei relevante Benchmarks.
Tokenreduktion #
Das How-it-works-Dokument berichtet:
| Korpus | Dateien | Reduktion |
|---|---|---|
| Karpathy-Repositories, Papers und Bilder | 52 | 71,5-fach |
| Graphify-Quellcode und Transformer-Paper | 4 | 5,4-fach |
| Synthetische httpx-Bibliothek | 6 | ca. 1-fach |
Auf den ersten Blick scheinen 71,5-mal weniger Tokens nicht zu meinem Anstieg von 49,5 % zu passen. Die Messungen verwenden unterschiedliche Ausgangswerte. Graphifys benchmark.py vergleicht eine Schätzung des gesamten Korpus mit einer Schätzung einer begrenzten Graph-Abfrage. Meine Baseline verwendete rg, find und gezieltes Lesen, während meine Messung auch Konversationsverlauf, Werkzeugergebnisse und jeden Modellaufruf umfasst.
Graphkompression kann also real sein, während die Eingabe eines Agenten von Anfang bis Ende steigt. Ein Retrieval-Werkzeug sollte mit der gezielten Suche und dem gezielten Lesen verglichen werden, die ein fähiger Coding-Agent bereits beherrscht, nicht nur damit, ein ganzes Repository in den Kontext zu legen.
Code Intelligence #
Graphifys veröffentlichter Benchmarkbericht enthält einen näheren Vergleich. Bei sechs bewerteten Fragen über das ERPNext-Repository mit ungefähr einer Million Zeilen verbesserte ein fester Coding-Agent laut Bericht die Abdeckung zentraler Fakten von 70,8 % mit grep- und Lesewerkzeugen auf 82,0 %, wenn ihm ein Graphify-Werkzeug gegeben wurde. Der Bericht nennt ungefähr 140.000 Tokens pro Abfrage.
Die Bewertungsmethode ist besser als meine, weil Antworten gegen atomare Schlüsselfakten geprüft werden. Trotzdem handelt es sich um ein selbst veröffentlichtes Ergebnis aus Graphifys eigener Harness mit nur sechs Fragen und aggregierten Ergebnissen. Verwendet werden ein anderes Modell, Repository und eine andere Graphify-Implementierung, während mein Experiment den Aufwand von Anfang bis Ende statt die Abdeckung von Schlüsselfakten misst.
Die Ergebnisse widersprechen sich nicht, aber keines von beiden zeigt eine breite Nützlichkeit. Zusammen legen sie eine engere Hypothese nahe, die sich zu testen lohnt: Graphifys Wert könnte mit der Größe des Repositories und der Breite der Fragen steigen, während sein Aufwand bei einfacher Navigation, die gewöhnliche Suche bereits erledigt, dominiert.
Was ich schlussfolgern kann und was nicht #
Durch die Messungen gestützt #
Für die elf einbezogenen FastAPI-Fragen und diese Konfiguration gilt:
- Graphify verringerte die Zahl der untersuchten Dateien in acht Fragen, mit einem Gleichstand.
- Graphify verringerte die Zahl der Werkzeugaufrufe in sieben Fragen.
- Die Gesamteingabe sank in keiner Frage.
- Insgesamt war Graphify langsamer.
- Die beobachteten Kosten waren insgesamt 9,5 % höher, noch ohne die Graph-Erstellung.
- Am meisten half es bei der breiten Erkundung von Tests und Änderungsfolgen.
- Der Agent verwendete nach der Graph-Abfrage weiterhin Quellsuche und Dateilesen.
Durch die Messungen nicht gestützt #
Ich kann nicht schlussfolgern, dass:
- Graphify korrektere Antworten erzeugte.
- die Antworten ohne Graphify korrekter waren.
- ein Durchlauf pro Frage die normale Modellvarianz abbildet.
- sich das Ergebnis auf jedes Repository, Modell oder jede Graphify-Version übertragen lässt.
Der fehlende Korrektheits-Benchmark ist die größte Einschränkung. Ein künftiges Experiment sollte atomare erwartete Fakten definieren, bevor die Sitzungen ausgeführt werden. Für Aufgaben zu Änderungsfolgen könnten historische Pull Requests als Referenz dienen, indem vorhergesagte Dateien mit der tatsächlich gemergten Änderung verglichen werden.
Weitere Einschränkungen #
Ein Durchlauf pro Frage und Konfiguration #
Das Modellverhalten ist stochastisch. Jede Frage sollte mehrmals ausgeführt und die Reihenfolge der Läufe randomisiert werden, um Werkzeugeffekte von gewöhnlicher Schwankung zu trennen.
Cache-Verhalten #
Die Sitzungsexporte enthalten Prompt-Cache-Lese- und Schreibvorgänge. Gecachte Eingabe kann anders berechnet werden als nicht gecachte Eingabe. Daher sollten sich Gesamteingabe und Geldkosten nicht proportional verändern. Der zusätzliche Graphify-Skill verändert außerdem den Prompt-Präfix und kann die Cache-Effektivität beeinflussen.
Die beobachteten Kosten verwenden die während jeder Sitzung aufgezeichneten Provider-Schätzungen einschließlich des aufgetretenen Cache-Verhaltens. Da ich Ausführungsreihenfolge, Aufwärmen und Provider-Cache-Zustand nicht kontrolliert habe, beschreibt der Kostenvergleich diese Läufe und keinen stabilen Preisvergleich ohne Cache. Ich habe alle Eingabekategorien zu Gesamteingabe zusammengefasst, anstatt einen kontrollierten Cache-Vergleich zu behaupten.
Die Fragen unterscheiden sich in ihrer Präzision #
Q3 ist zu vage, und die Fragen zu Änderungsfolgen erlauben mehrere gültige Interpretationen. Eine künftige Version sollte konkrete Optionen und erwartetes Verhalten benennen.
Der Aufwand für die Erstellung wurde nicht amortisiert #
Die Tabellen pro Frage schließen die 3,8 Millionen Eingabe- und 349.000 Ausgabe-Tokens aus, die für die Graph-Erzeugung verwendet wurden. Selbst ohne den Kosten der Erstellung einen Geldwert zuzuweisen, hatten die Graphify-Sitzungen insgesamt höhere beobachtete Kosten. Wiederverwendung könnte die Erstellungskosten amortisieren, würde aber die in diesen Läufen beobachtete Prämie pro Abfrage nicht beseitigen.
Auch die Aktualität des Graphen verursacht operativen Aufwand. Aktualisierungen nach Pulls und Merges, Verantwortung in CI und erzeugte Artefakte könnten in einem großen Team wichtig sein, aber ich habe diese Belastung nicht gemessen. Sie bleibt ein weiterer unbewiesener Teil des Wertversprechens für große Repositories.
Wann ich Graphify verwenden würde #
Auf Grundlage dieses Experiments und des veröffentlichten Designs von Graphify würde ich es nur dann weiter evaluieren, wenn:
- das Repository sehr groß und unbekannt ist,
- Fragen viele Pakete oder Schichten überschreiten,
- ich wiederholt Änderungsfolgen analysieren muss,
- Code, Architektur-Dokumente, wissenschaftliche Arbeiten und andere Medien gemeinsam durchsucht werden sollen,
- derselbe Graph oft genug wiederverwendet wird, um die Erstellung zu amortisieren,
- ich Beziehungen verfolgen muss, die sich nur schwer als lexikalische Suche ausdrücken lassen.
Ich würde wahrscheinlich darauf verzichten, wenn:
- ich eine bekannte Klasse, Funktion oder einen bekannten Konfigurationsnamen finden muss,
- das Repository klein genug für gezielte Suche und Dateilesen ist,
- ich nur eine oder zwei Fragen habe,
- der Graph schnell veralten würde,
- ich nicht rechtfertigen kann, Dokumentation oder andere Assets an ein semantisches Extraktions-Backend zu senden.
Ein praktischer hybrider Workflow #
Das Experiment legt nahe, dass „Graphify statt grep“ das falsche mentale Modell ist. Ein sicherer Workflow sieht so aus:
- Frage den Graphen nach möglichen Symbolen, Dateien und Pfaden ab.
- Bevorzuge nach Möglichkeit
EXTRACTED-Beziehungen gegenüber abgeleiteten Beziehungen. - Überprüfe wichtige Graphbeziehungen im Quellcode.
- Verwende eine exakte Suche für Deklarationen und Referenzen.
- Begrenze den Graphen für fokussierte Arbeit auf relevante Verzeichnisse.
- Behandle den Graphen als Index, nicht als letzte Instanz.
So verhielt sich auch der Graphify-Agent. Der Graph gab Orientierung, während Quelltextlektüre Belege lieferte.
Fazit: eine nützliche Karte, aber kein grep-Ersatz #
Graphify ist mehr als ein schicker HTML-Graphgenerator. Es erstellt einen abfragbaren strukturellen Index und zeigt Beziehungen, die sich lexikalisch nur schwer entdecken lassen. Diese Fähigkeit ist real. Ihre Nützlichkeit für einen Coding-Agenten folgt jedoch nicht allein aus ihrer Existenz.
In meinem Experiment ersetzte Graphify grep nicht. In jeder Graphify-Sitzung fragte der Agent den Graphen ab und verwendete danach Quellsuchen oder Dateilesen zur Überprüfung. Bei einfacher Navigation und sogar bei mehreren Fragen über mehrere Dateien hinweg war der Graph meist ein zusätzlicher Retrieval-Schritt vor der Quelltextprüfung. Das gemessene Ergebnis waren mehr Eingabe und höhere Latenz. Ob sich die Antwortqualität genug verbesserte, um beides zu rechtfertigen, habe ich nicht gemessen.
Auch die Vorlaufkosten sind wichtig. Ich verbrauchte 3,8 Millionen Eingabe-Tokens und 349.000 Ausgabe-Tokens für die Erstellung des Graphen. Danach verarbeiteten die Graphify-Sitzungen 49,5 % mehr Eingabe als die Baseline und hatten in neun der elf einbezogenen Fragen höhere beobachtete Kosten. Bei den gemessenen Effizienzergebnissen zahlte sich diese Investition nicht aus. Mehr Wiederverwendung würde die Erstellungskosten verteilen, aber die beobachteten Kosten pro Abfrage waren in diesen Läufen ebenfalls höher. Wiederverwendung allein behebt die gezeigte Wirtschaftlichkeit daher nicht. Eine unabhängige Qualitätsbewertung könnte dieses Urteil ändern, wenn sie zeigte, dass die Prämie zuverlässig bessere Antworten erkauft.
Mein aktuelles Urteil ist skeptischer als „nützlich für große Repositories“. Auf Grundlage der Effizienzbelege aus diesem Experiment würde ich Graphify nicht übernehmen. Ich würde eine stärkere Bewertung an einer großen, langlebigen Codebasis mit wiederholter Arbeit über mehrere Bereiche hinweg, unabhängig bewerteten Antworten und historischen Änderungen als Ground Truth durchführen. Solange ein solcher Test keine besseren Antworten oder verlässliche Zeitersparnis zeigt, bleibt gezielte Quellsuche die einfachere und besser belegte Standardeinstellung.
Am wichtigsten ist, dass dieses Experiment die Frage verändert hat, die ich an jedes KI-Werkzeug für Code-Intelligenz stellen würde. „Komprimiert es das Repository?“ reicht nicht. Die nützliche Frage lautet: Hilft es einem Agenten, schneller und günstiger zu einer gut belegten Antwort zu gelangen als eine gezielte Suche im Quellcode?
Für dieses FastAPI-Experiment lautet die Antwort noch nicht überzeugend ja.
Rohdaten #
Die einzelnen Messungen und vollständigen exportierten Sitzungen sind unten enthalten, damit der Vergleich geprüft und reproduziert werden kann.
Ohne Graphify #
| Q | Zeit | Dateien | Tools | Graph | Input | Output | Kosten | Rohdaten |
|---|---|---|---|---|---|---|---|---|
| Q1 | 23 | 2 | 8 | 0 | 50.483 | 881 | $0,0059 | Sitzung |
| Q2 | 28 | 8 | 12 | 0 | 86.642 | 2.610 | $0,0117 | Sitzung |
| Q3 (ausgeschlossen) | 42 | 6 | 14 | 0 | 104.745 | 1.921 | $0,0107 | Sitzung |
| Q4 | 27 | 6 | 15 | 0 | 156.190 | 2.239 | $0,0132 | Sitzung |
| Q5 | 32 | 4 | 10 | 0 | 125.938 | 2.987 | $0,0154 | Sitzung |
| Q6 | 37 | 4 | 14 | 0 | 197.980 | 2.289 | $0,0163 | Sitzung |
| Q7 | 36 | 8 | 19 | 0 | 218.382 | 2.650 | $0,0163 | Sitzung |
| Q8 | 35 | 5 | 12 | 0 | 183.568 | 2.662 | $0,0144 | Sitzung |
| Q9 | 60 | 17 | 17 | 0 | 218.802 | 3.013 | $0,0167 | Sitzung |
| Q10 | 46 | 7 | 21 | 0 | 178.837 | 2.165 | $0,0149 | Sitzung |
| Q11 | 43 | 8 | 18 | 0 | 319.530 | 3.319 | $0,0262 | Sitzung |
| Q12 | 101 | 20 | 29 | 0 | 237.930 | 2.823 | $0,0177 | Sitzung |
Mit Graphify #
| Q | Zeit | Dateien | Tools | Graph | Input | Output | Kosten | Rohdaten |
|---|---|---|---|---|---|---|---|---|
| Q1 | 52 | 2 | 7 | 3 | 122.192 | 1.141 | $0,0081 | Sitzung |
| Q2 | 19 | 5 | 9 | 3 | 110.969 | 988 | $0,0083 | Sitzung |
| Q3 (ausgeschlossen) | 41 | 6 | 12 | 3 | 147.471 | 1.807 | $0,0126 | Sitzung |
| Q4 | 46 | 5 | 19 | 4 | 353.484 | 2.520 | $0,0203 | Sitzung |
| Q5 | 61 | 3 | 20 | 3 | 314.420 | 3.192 | $0,0191 | Sitzung |
| Q6 | 41 | 5 | 17 | 3 | 281.416 | 2.545 | $0,0169 | Sitzung |
| Q7 | 64 | 7 | 15 | 3 | 323.928 | 2.882 | $0,0172 | Sitzung |
| Q8 | 45 | 3 | 21 | 3 | 261.055 | 2.920 | $0,0186 | Sitzung |
| Q9 | 41 | 12 | 11 | 3 | 312.040 | 2.646 | $0,0180 | Sitzung |
| Q10 | 45 | 8 | 12 | 3 | 294.761 | 2.035 | $0,0161 | Sitzung |
| Q11 | 50 | 7 | 14 | 3 | 337.304 | 3.281 | $0,0229 | Sitzung |
| Q12 | 47 | 19 | 15 | 3 | 240.162 | 3.054 | $0,0192 | Sitzung |